Notatki, które porządkuje AI. Od metody Tiaga Fortego do wiki prowadzonej przez model
Drugi mózg
12 min czytaniaAutor: Juliusz Tomeczek
Seria o drugim mózgu, odcinek 2 z 4: metoda w świecie cyfrowym
🎧 Posłuchaj podcastu o tym artykule
Na kartce 9/8,1 Niklas Luhmann zastanawiał się, jak zrobić z kartoteki partnera do pracy, „młodszego wspólnika”, skoro praca z zatrudnionymi pomocnikami staje się coraz trudniejsza i droższa. W pierwszym odcinku tej serii pokazałem, jak działała jego papierowa kartoteka. Ten odcinek opowiada, co z metodą Luhmanna zrobiły komputery.
Od pierwszych pomysłów na maszynę wspierającą ludzką pamięć minęło osiemdziesiąt lat. W tym czasie komputery nauczyły się przechowywać notatki, wyszukiwać je i łączyć odnośnikami. Nie nauczyły się jednego: dbać o porządek, gdy notatek przybywa. Tę pracę nadal wykonywał człowiek, a ponieważ była żmudna, wiele osób porzucało swój system notatek właśnie wtedy, gdy zbiór zaczynał się rozrastać. Dopiero model językowy może ją przejąć, dlatego jest pierwszym poważnym kandydatem na wspólnika, o którym myślał Luhmann. Od razu zgłaszam jedno zastrzeżenie, do którego wrócę pod koniec: przejęcie porządkowania to nie to samo co przejęcie myślenia.
Przykłady biorę z kancelarii prawnej, z wdrożeń systemów informatycznych w firmach i ze sprzedaży, bo w każdej z tych dziedzin codziennie przybywa dokumentów, notatek z rozmów i ustaleń, do których trzeba potem wracać.
Marzenie o maszynie wspierającej pamięć
W lipcu 1945 roku miesięcznik „The Atlantic Monthly” opublikował esej Vannevara Busha „As We May Think” (otwiera się w nowej karcie). Bush, amerykański inżynier i wynalazca, opisał w nim urządzenie o nazwie Memex: biurko, w którym użytkownik miał przechowywać wszystkie swoje książki, zapiski i korespondencję, a potem bardzo szybko do nich sięgać. Bush widział w Memeksie osobiste przedłużenie pamięci, które pomieści o wiele więcej, niż człowiek zdoła zapamiętać.
Najważniejszy pomysł Busha to ścieżki skojarzeń. Bush zauważył, że dokumenty odnajduje się w katalogach według haseł, a umysł pracuje inaczej: przechodzi od jednej myśli do drugiej przez skojarzenia. W Memeksie użytkownik miał więc łączyć dokumenty w takie ścieżki, a każdy dokument mógł należeć do wielu ścieżek naraz. Kto zna pierwszy odcinek, łatwo rozpozna w tych ścieżkach odsyłacze Luhmanna. Odnośniki między notatkami we współczesnych aplikacjach wywodzą się wprost z obu tych pomysłów: ze ścieżek Busha i z odsyłaczy Luhmanna.
Tiago Forte, twórca metody opisanej w następnej części, zalicza Busha do pionierów, którzy marzyli o technologii wzmacniającej ludzki intelekt. Obok niego wymienia cztery inne osoby:
- Paul Otlet (otwiera się w nowej karcie), który od 1895 roku budował z Henrim La Fontaine’em kartotekę faktów liczącą ostatecznie ponad 15 milionów wpisów;
- Doug Engelbart (otwiera się w nowej karcie), który czytał esej Busha, a w 1968 roku publicznie pokazał mysz komputerową i hipertekst;
- Ted Nelson (otwiera się w nowej karcie), który ukuł słowo „hipertekst”;
- Alan Kay (otwiera się w nowej karcie), który obmyślił Dynabook, pierwowzór laptopa i tabletu.
Każdy z nich rozwiązał inną część problemu, ale żaden nie odpowiedział na pytanie, które w 2026 roku Andrej Karpathy, jeden z założycieli OpenAI, uznał za najważniejszy: kto ma na bieżąco dbać o wszystkie powiązania między notatkami.
Drugi mózg Tiaga Fortego
Nazwę „drugi mózg” spopularyzował Tiago Forte (otwiera się w nowej karcie), autor książki Building a Second Brain (otwiera się w nowej karcie), wydanej w czerwcu 2022 roku (po polsku Zbuduj swój drugi mózg (otwiera się w nowej karcie), 2023). Do swojej metody Forte doszedł za sprawą choroby. Przez lata cierpiał na ból gardła, którego przyczyny lekarze nie potrafili ustalić. W końcu zebrał w jednym miejscu całą dokumentację medyczną, własnymi słowami opisał przebieg choroby, spisał wszystkie terapie, jakich próbował, i dopiero w tych notatkach zaczął dostrzegać prawidłowości, których wcześniej nie widział. Z tego doświadczenia wyciągnął wniosek, na którym oparł całą książkę: notatki pozwalają spojrzeć na sprawę z dystansu i zobaczyć ją w całości.
Metoda Fortego składa się z czterech kroków, a pierwsze litery ich angielskich nazw tworzą skrót CODE:
- Zapisz (Capture). Zachowuj tylko to, co Cię porusza, zaskakuje albo może się przydać. Zachowane fragmenty zajmują zwykle nie więcej niż jedną dziesiątą źródła.
- Uporządkuj (Organize). Układaj notatki według tego, w jakiej pracy się przydadzą, a nie według tematu.
- Wydestyluj (Distill). Wydobądź z zapisanego materiału sedno, tak żeby notatka była użyteczna także za pół roku.
- Wyraź (Express). Wykorzystaj notatki w pracy i pokaż jej efekt innym.
Do porządkowania notatek Forte proponuje cztery kategorie, których angielskie nazwy (Projects, Areas, Resources, Archives) zaczynają się od liter składających się na skrót PARA: projekty, czyli sprawy, które mają początek i koniec, a pracujesz nad nimi teraz; obszary, czyli stałe obowiązki, które nie mają końca; zasoby, czyli tematy, które mogą się kiedyś przydać; i archiwa, czyli wszystko, czym już się nie zajmujesz. Oto przykład z wdrożenia systemu: na warsztacie z klientem zapisujesz uwagę o akceptacji faktur. Notatka nie trafia do folderu „finanse”, tylko do folderu bieżącego wdrożenia. Gdy projekt się kończy, notatki przydatne przy kolejnym wdrożeniu przenosisz do zasobów, a resztę folderu do archiwum.
Do wydobywania sedna notatek Forte proponuje stopniowe streszczanie. W zapisanej notatce najpierw pogrubiasz najważniejsze fragmenty, potem zakreślasz najistotniejsze spośród pogrubionych, a na górze dopisujesz kilka zdań własnymi słowami. Forte radzi streszczać notatkę dopiero wtedy, gdy jest potrzebna do pracy, bo streszczanie zajmuje czas, a z góry nie wiadomo, które notatki się przydadzą.
Warto zobaczyć, czym ta metoda różni się od kartoteki Luhmanna. Luhmann porządkował myśli, a Forte porządkuje materiał do pracy. Luhmann pisał własne notatki stałe i łączył je odsyłaczami, a Forte zbiera przede wszystkim fragmenty źródeł, układa je w folderach projektów i streszcza, gdy są potrzebne. Obie metody działają, ale w obu całą pracę wykonuje człowiek.
Słaby punkt cyfrowych systemów notatek
Aplikacje do notatek dały to, o czym Bush mógł tylko marzyć: wyszukiwarkę, przejście do powiązanej notatki jednym kliknięciem i dostęp z telefonu. Nie zdjęły jednak z człowieka pracy porządkowej. Ktoś musi przenieść notatkę z projektu do archiwum, poprawić streszczenie, gdy pojawi się nowe źródło, dopisać odnośnik do notatki sprzed roku i zauważyć, że nowa informacja przeczy starej.
Karpathy (otwiera się w nowej karcie) opisał ten problem wprost: ludzie porzucają swoje prywatne wiki, czyli zbiory połączonych ze sobą stron z notatkami, bo nakład pracy na utrzymanie w nich porządku rośnie szybciej niż korzyść, jaką z nich mają. Czytanie i myślenie sprawiają przyjemność, a żmudne pilnowanie porządku w notatkach męczy. Gdy porządkowanie odkłada się przez kilka tygodni, notatki rozmijają się z rzeczywistością, nikt już im nie ufa, a cały system szybko zamienia się w zwykły folder z plikami.
Forte wydał swoją książkę kilka miesięcy przed premierą ChatGPT, więc w jego metodzie każdy krok wykonuje człowiek. Ta uwaga nie jest zarzutem wobec Fortego, tylko przypomnieniem o tym, kiedy powstała jego metoda.
Model jako wspólnik
W kwietniu 2026 roku Karpathy opublikował krótką notatkę „LLM Wiki” (otwiera się w nowej karcie). Opisał w niej, jak model językowy może przejąć pracę porządkową, przez którą ludzie porzucają swoje notatki.
Różnicę między zwykłą rozmową z modelem a wzorcem Karpathy’ego najłatwiej zobaczyć na przykładzie ze sprzedaży. Zwykła rozmowa wygląda tak: po pięciu spotkaniach z klientem wklejasz do czatu pięć transkrypcji i pytasz, co ustalono w sprawie terminu realizacji. Model czyta wszystkie pięć transkrypcji i składa z nich odpowiedź, a po zamknięciu rozmowy z tej pracy nic nie zostaje. Przy następnym pytaniu model znowu czyta wszystkie transkrypcje od początku.
We wzorcu Karpathy’ego model czyta każdą transkrypcję tylko raz, tuż po spotkaniu. Od razu dopisuje do karty klienta ustalenia, terminy, obietnice obu stron, zgłoszone zastrzeżenia i informację o tym, kto po stronie klienta podejmuje decyzje. Jeśli klient zmienił zdanie co do zakresu zamówienia, model odnotowuje tę zmianę w karcie. Przed kolejnym spotkaniem wystarczy otworzyć kartę albo zapytać model, co zostało obiecane i które sprawy wciąż czekają na załatwienie.
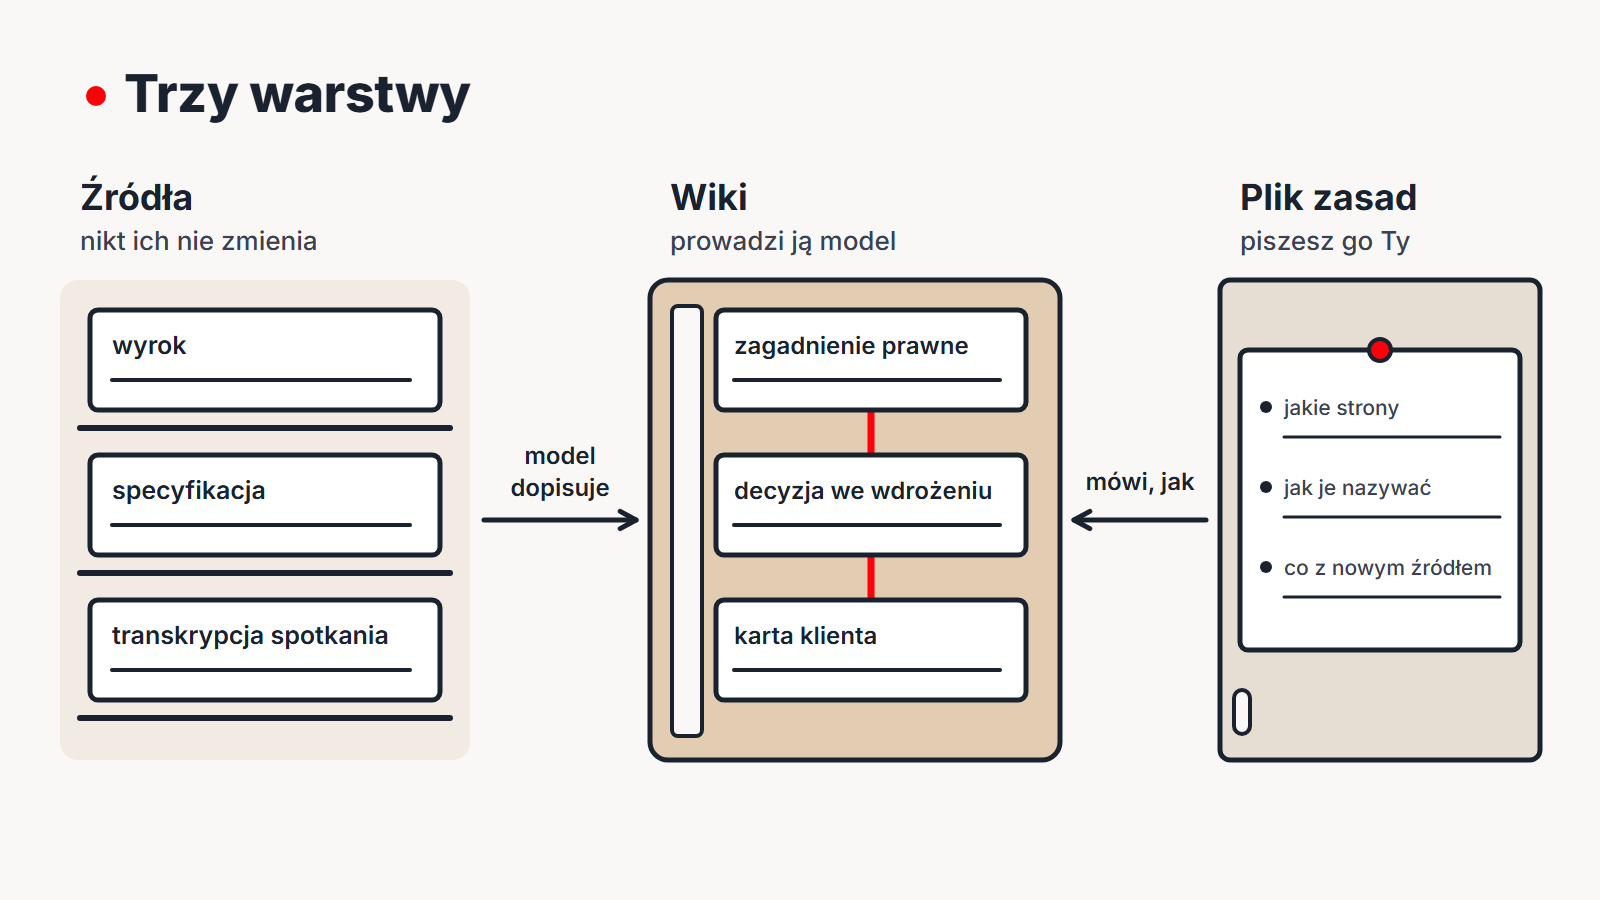
Wzorzec ma trzy warstwy. Źródła, czyli transkrypcje, dokumenty i artykuły, zbierasz Ty i nikt ich nie zmienia, nawet model. Wiki, czyli połączone ze sobą strony z wiedzą wydobytą ze źródeł, prowadzi model: to on je pisze i aktualizuje. Plik zasad piszesz Ty. Opisujesz w nim, jak model ma prowadzić wiki: jakie strony zakładać, jak je nazywać i co robić z nowym źródłem. Do tego dochodzą trzy czynności: dodanie źródła, pytanie do systemu i okresowy przegląd, w którym model szuka sprzeczności oraz stron, do których nie prowadzi żaden odnośnik.
Pełny opis wzorca i to, jak działa u mnie po kilku miesiącach codziennej pracy, przedstawiłem w artykule Drugi mózg według Karpathy’ego na stronie JT CONSULTING.
Trzy dziedziny, jeden wzorzec
Ten sam układ sprawdza się w każdej pracy, w której wiedza napływa z wielu źródeł, a trzeba ją mieć pod ręką także za miesiąc albo za rok.
| Dziedzina | Źródła, których nikt nie zmienia | Strony, które prowadzi model | Pytanie do systemu |
|---|---|---|---|
| kancelaria prawna | wyroki, glosy, pisma w sprawie | zagadnienie prawne, orzecznictwo w danej kwestii, sprawa | „Które wyroki z ostatnich dwóch lat przeczą mojej tezie?” |
| wdrożenie systemu | specyfikacja, notatki z warsztatów, dokumentacja klienta | moduł systemu, decyzja z uzasadnieniem, otwarte kwestie | „Dlaczego przyjęliśmy dwa poziomy akceptacji faktur i kto to zatwierdził?” |
| sprzedaż | transkrypcje i notatki ze spotkań, oferty, korespondencja | karta klienta, ustalenia, zastrzeżenia, osoby decydujące | „Co zostało obiecane temu klientowi i które sprawy wciąż czekają na załatwienie?” |
W każdej z tych dziedzin model robi to samo: prowadzi strony i zaznacza sprzeczności między źródłami. Różni się tylko materiał i to, co z tej pracy zyskujesz:
- Kancelaria prawna. Model prowadzi stronę zagadnienia, która rośnie z każdym nowym wyrokiem. Gdy nowy wyrok przeczy wcześniejszym, model zaznacza tę sprzeczność, więc widać, w których kwestiach orzecznictwo jest rozbieżne.
- Wdrożenie systemu. Model prowadzi bazę wiedzy o projekcie, w której każda decyzja ma stronę z uzasadnieniem i datą. Gdy na warsztacie pada ustalenie sprzeczne ze specyfikacją, model zaznacza sprzeczność na stronie decyzji, więc rozbieżność wychodzi na jaw od razu, a nie dopiero przy odbiorze systemu. Z takich stron łatwo potem złożyć dokumentację wdrożenia.
- Sprzedaż. Model prowadzi kartę klienta, do której trafiają ustalenia z każdej rozmowy, więc nie trzeba pamiętać wszystkich szczegółów z kilkunastu spotkań. Gdy klient zmieni zdanie, model odnotowuje tę zmianę w karcie.
Luhmann, Forte i Karpathy obok siebie
Trzy metody dzieli kilkadziesiąt lat, ale odpowiadają na te same pytania. Różnią się przede wszystkim tym, kto wykonuje pracę.
| Kartoteka Luhmanna | Drugi mózg Fortego | Wiki Karpathy’ego | |
|---|---|---|---|
| Gdzie trafia źródło | kartoteka bibliograficzna | zasoby w PARA | źródła, których nikt nie zmienia |
| Gdzie trafia myśl | kartka w kartotece głównej | notatka po streszczeniu | strona wiki |
| Jak łączą się notatki | numer i odsyłacz | folder projektu | odnośniki, które dopisuje model |
| Od czego zaczyna się szukanie | indeks haseł | wyszukiwarka i foldery | spis stron |
| Gdzie są zasady | w głowie Luhmanna | w książce | w pliku zasad, który rośnie razem z systemem |
| Kto utrzymuje porządek | Luhmann | Ty | model |
| Kto myśli | Luhmann | Ty | Ty, z modelem jako wspólnikiem |
Kto ma pisać notatki
Karpathy zaznacza, że człowiek prawie nigdy sam nie redaguje wiki: całą pracę redakcyjną wykonuje model, a do człowieka należy dobór źródeł, zadawanie pytań i namysł nad tym, co wynika z zebranej wiedzy. Sönke Ahrens, na którego książce opierał się pierwszy odcinek, przytacza z kolei zdanie Terry’ego Doyle’a, badacza procesu uczenia się: „uczy się ten, kto wykonuje pracę”. Na pierwszy rzut oka Karpathy i Ahrens sobie przeczą. Jeśli wszystko pisze model, to kto się uczy?
Moim zdaniem Karpathy i Ahrens mają rację, tylko mówią o różnych rzeczach. Karpathy mówi o pamięci, czyli o streszczaniu źródeł, dopisywaniu odnośników, prowadzeniu spisu stron i wyłapywaniu sprzeczności. Ta praca przypomina prowadzenie księgowości: jest żmudna, ale konieczna. Model wykonuje ją lepiej niż człowiek, ponieważ się nie nudzi i nie zapomina. Ahrens mówi o zrozumieniu, a do zrozumienia prowadzi tylko własna teza: kto formułuje ją samodzielnie, ten naprawdę rozumie temat, o którym pisze.
Dlatego proponuję prosty podział. Księgowość wiedzy oddaj modelowi, a notatki z własną tezą pisz samodzielnie, tak jak notatki stałe w ćwiczeniu z pierwszego odcinka. Model streszcza nowy wyrok i dopisuje go do strony zagadnienia, ale ocenę, czy ten wyrok zmienia stanowisko w prowadzonej sprawie, zostawiasz sobie. Model wypisuje z transkrypcji wszystkie ustalenia i terminy, ale wniosek, czy klient jest gotowy do decyzji i co mu zaproponować na następnym spotkaniu, formułujesz Ty.
Bez tego podziału drugi mózg daje pamięć, ale nie daje zrozumienia, o czym pisałem w pierwszym odcinku. Przy takim podziale daje jedno i drugie.
Na co uważać
Model pisze płynnie, więc wniosek brzmi jak fakt. Twierdzenie, które model sam wywnioskował, a nie wyczytał ze źródła, brzmi równie pewnie jak twierdzenie sprawdzone. Przy ważnych stronach proś model o wskazanie źródła każdego twierdzenia, a to, czego nie potwierdza żadne źródło, traktuj jak hipotezę.
Źródeł nie poprawia nikt. Tylko nietknięte źródło pozwala sprawdzić, czy strona wiki zgadza się z tym, co w nim zapisano. Jeśli model poprawi transkrypcję albo specyfikację, zabraknie oryginału, z którym można by porównać stronę wiki.
Część źródeł należy do kogoś innego. Akta sprawy, dokumentacja klienta i transkrypcja rozmowy zawierają cudze informacje, często także dane osobowe. Zanim trafią do modelu, sprawdź, czy pozwalają na to umowa z klientem i warunki usługi, z której korzystasz.
Ćwiczenie na tydzień: zasady na jedną stronę
Zanim zainstalujesz jakikolwiek program, napisz zasady, których ma przestrzegać model prowadzący Twoje notatki. Kartka z zasadami będzie punktem wyjścia do budowy drugiego mózgu w trzecim odcinku, a do jej napisania nie potrzeba żadnego narzędzia.
- Rodzaje notatek. Wypisz, jakie rodzaje notatek prowadzisz, na przykład o sprawach, zagadnieniach i wyrokach; o projektach wdrożeniowych, decyzjach i otwartych kwestiach; albo o klientach, spotkaniach i ofertach.
- Nazwy. Ustal, jak będziesz nazywać notatki każdego rodzaju, żeby za rok od razu trafić na właściwą, bez przeszukiwania folderów.
- Nowe źródło. Opisz w kilku zdaniach, co ma się stać, gdy pojawi się nowy materiał: które strony trzeba uzupełnić i co dopisać do spisu stron.
- Czego nie wolno zmieniać. Wymień źródła, których model nie może poprawiać.
- Co piszesz samodzielnie. Wskaż notatki, których nigdy nie oddajesz modelowi: tezy, oceny i wnioski.
- Próba w codziennej pracy. Przez tydzień po każdej lekturze albo każdym spotkaniu zadaj sobie pytanie, czy z zasad wynika, gdzie ten materiał ma trafić. Jeśli zasady tego nie rozstrzygają, dopisz brakującą regułę.
Napisanie pierwszej wersji zasad zajmuje mniej więcej pół godziny. To moje oszacowanie, a nie wynik badań. Po tygodniu poprawek kartka opisuje już Twój własny sposób pracy, a nie ogólny wzór z poradnika.
Co dalej
W trzecim odcinku zbudujemy drugi mózg: zaczniemy od pustego folderu, a skończymy na pierwszym pytaniu, na które system odpowie lepiej niż zwykłe wyszukiwanie w plikach. Punktem wyjścia będzie kartka z zasadami z tego ćwiczenia. Kolejne odcinki serii wyślę w newsletterze. Zapisz się na newsletter, żeby ich nie przegapić.
Źródła
- Andrej Karpathy, „LLM Wiki” (otwiera się w nowej karcie), 4 kwietnia 2026.
- Tiago Forte, Building a Second Brain (otwiera się w nowej karcie), Atria Books, 2022 (po polsku: Zbuduj swój drugi mózg (otwiera się w nowej karcie), 2023).
- Vannevar Bush, As We May Think (otwiera się w nowej karcie), „The Atlantic Monthly” 176 (1945), nr 1, s. 101–108.
- Sönke Ahrens (otwiera się w nowej karcie), How to Take Smart Notes. One Simple Technique to Boost Writing, Learning and Thinking (otwiera się w nowej karcie), wydanie drugie, 2022.
- Przekład ciągu kartek 9/8 Niklasa Luhmanna na angielski: zettelkasten.de (otwiera się w nowej karcie), 31.10.2022.
Ten tekst powstał z użyciem narzędzi sztucznej inteligencji, bo tak pracuję na co dzień i takiej pracy uczę innych. Każde twierdzenie w nim sprawdziłem i odpowiadam za nie osobiście. Okładka i schemat to grafiki wektorowe zapisane w kodzie, który również powstał z pomocą AI. Rozmowę w nagraniu wygenerował NotebookLM na podstawie tego tekstu, a przed publikacją odsłuchałem ją w całości.
Juliusz Tomeczek, AI for Everyone
O autorze
Juliusz Tomeczek
Nazywam się Juliusz Tomeczek. Prowadzę blog AI for Everyone i publikuję tu artykuły o sztucznej inteligencji.
Powiązane artykuły
12 min czytania
Zettelkasten krok po kroku. Metoda Luhmanna, zanim pojawiły się aplikacje i AI
Zanim powstały aplikacje do notatek, Niklas Luhmann prowadził kartotekę liczącą 90 tysięcy kartek i sam nazywał ją drugą pamięcią. Piszę, jak działała, jakie notatki w niej powstawały i jak przez tydzień wypróbować tę metodę na papierze.
- #Drugi mózg
- #AI w pracy prawnika